Day 3:PlugScribe 录音接入与全自动转录工作流
前两天我们跑通了基础环境与 Agent 的基本指挥。今天进入极其关键的一环:如何源源不断地给你的 AI 工作台喂入最真实、最高密度的业务原材料?
很多做业务的老板每天忙到脚不沾地,根本没时间坐在电脑前敲几千字日记。语音与会议录音,是超级个体建立个人资产最轻、最快的一手原料(RAW 信号)。
但很多人遇到的困境是:录音存了一大堆,全烂在手机和文件夹里,转成文字也是错字连篇的死文本,AI 根本用不起来。
今天这篇教程,就是为你彻底解决这个问题——从录音生成、接入 Obsidian,到建立专属热词库纠错,再到实现无人值守的自动化入库流水线!
一、 第零步:极简硬件闭环——买一支录音笔,装好软件,顺手一插
在讲复杂的 AI 自动化之前,我们先解决最物理、最现实的问题:录音是怎么来的?
很多人会说:“我用手机录音不行吗?” 手机录音的最大痛点在于:摩擦力太大!
- 见客户时掏出手机点开录音 App,动作太显眼、容易让对方警惕;
- 录到一半来个微信电话、或者屏幕熄屏,录音直接中断;
- 手机录完还要通过微信传到电脑,文件一多乱成一锅粥。
真正工业级的个人流水线,一定是“极简物理硬件 + 电脑自动化”的组合:
1. 硬件选型:任意录音笔都行,越纯粹越好
- 不需要买昂贵的 AI 联网录音笔(很多带所谓大模型转录的录音笔,不仅硬件死贵,而且还要年年收你几十甚至上百块的云端转录年费,隐私全在别人服务器上);
- 买任意普通的 USB 录音笔即可:从几十块钱的普通品牌,到几百块经典的索尼(如 PX470 等),只要具备一个核心能力——能插在电脑上被识别为一个 U 盘、里面能拷贝出
.mp3或.wav音频文件,就完全足够了! - 它的好处是:小巧轻便、物理推钮一键盲操、放兜里不显眼、超长待机、不会被电话打断。
2. 安装 PlugScribe 客户端(河公子开发的转录小工具)
- 前往 0ma.ai/plugscribe 下载并安装 PlugScribe 客户端;
- 关于这套工具:PlugScribe 是河公子在自己的一人公司工作台里开发自用的小工具。因为受够了每次转录都要手动新建任务、选语言、点导出等繁琐步骤,所以核心就一个执念:“即插即转,0 次多余点击”。
- Mac 端:支持内嵌本地 Whisper,断网也能转;
- Windows / 高精度需求:支持配置 MiniMax API,转录费用约 2 元/小时,按实际调用付费;软件本身不收订阅费。
- 它负责把录音笔拷进来的音频在本地统一管理,转成规整的 Markdown 文本。没有月租绑架,用老旧录音笔也能轻松跑起来。
3. 任何业务场景,想录就录
- 客户深度沟通:进门前兜里一推按键开录,全程不碰手机,专注听客户讲话;
- 行业线下培训/听课:放桌角一开,不漏掉老师讲的任何一个细节;
- 散步/开车灵感:对着录音笔自言自语把新想法说出来。
4. 回家/回工位:顺手一插!
- 录完了,什么多余动作都不需要;
- 回到工位,把录音笔顺手往电脑 USB 接口上一插;
- 电脑直接弹出录音笔磁盘,PlugScribe 一键读取刚录完的音频,几十秒自动转录完成!
接下来,我们就把这段刚转录出来的文字,无缝接进 Obsidian AI 工作台。
二、 第一步:认识 PlugScribe 与找到原始转录文件
PlugScribe 是一个极简高效的离线音频转录中枢,目前仅支持 USB 录音设备;不能直接转录手机语音备忘录或会议录音。
很多新手以为转录完就结束了,其实关键在于:转录出来的文件在哪里?
-
定位录音与文本:
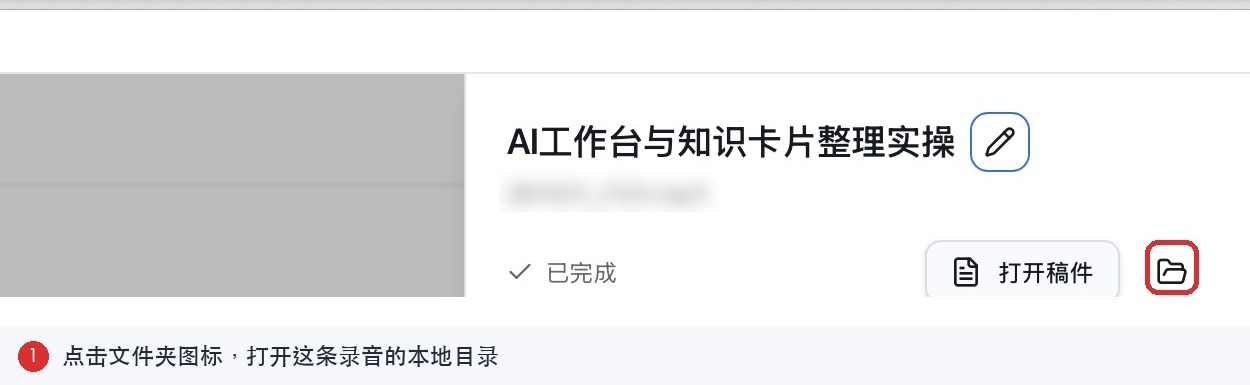
- 在 PlugScribe 录音库中点击对应录音,打开右侧详情;
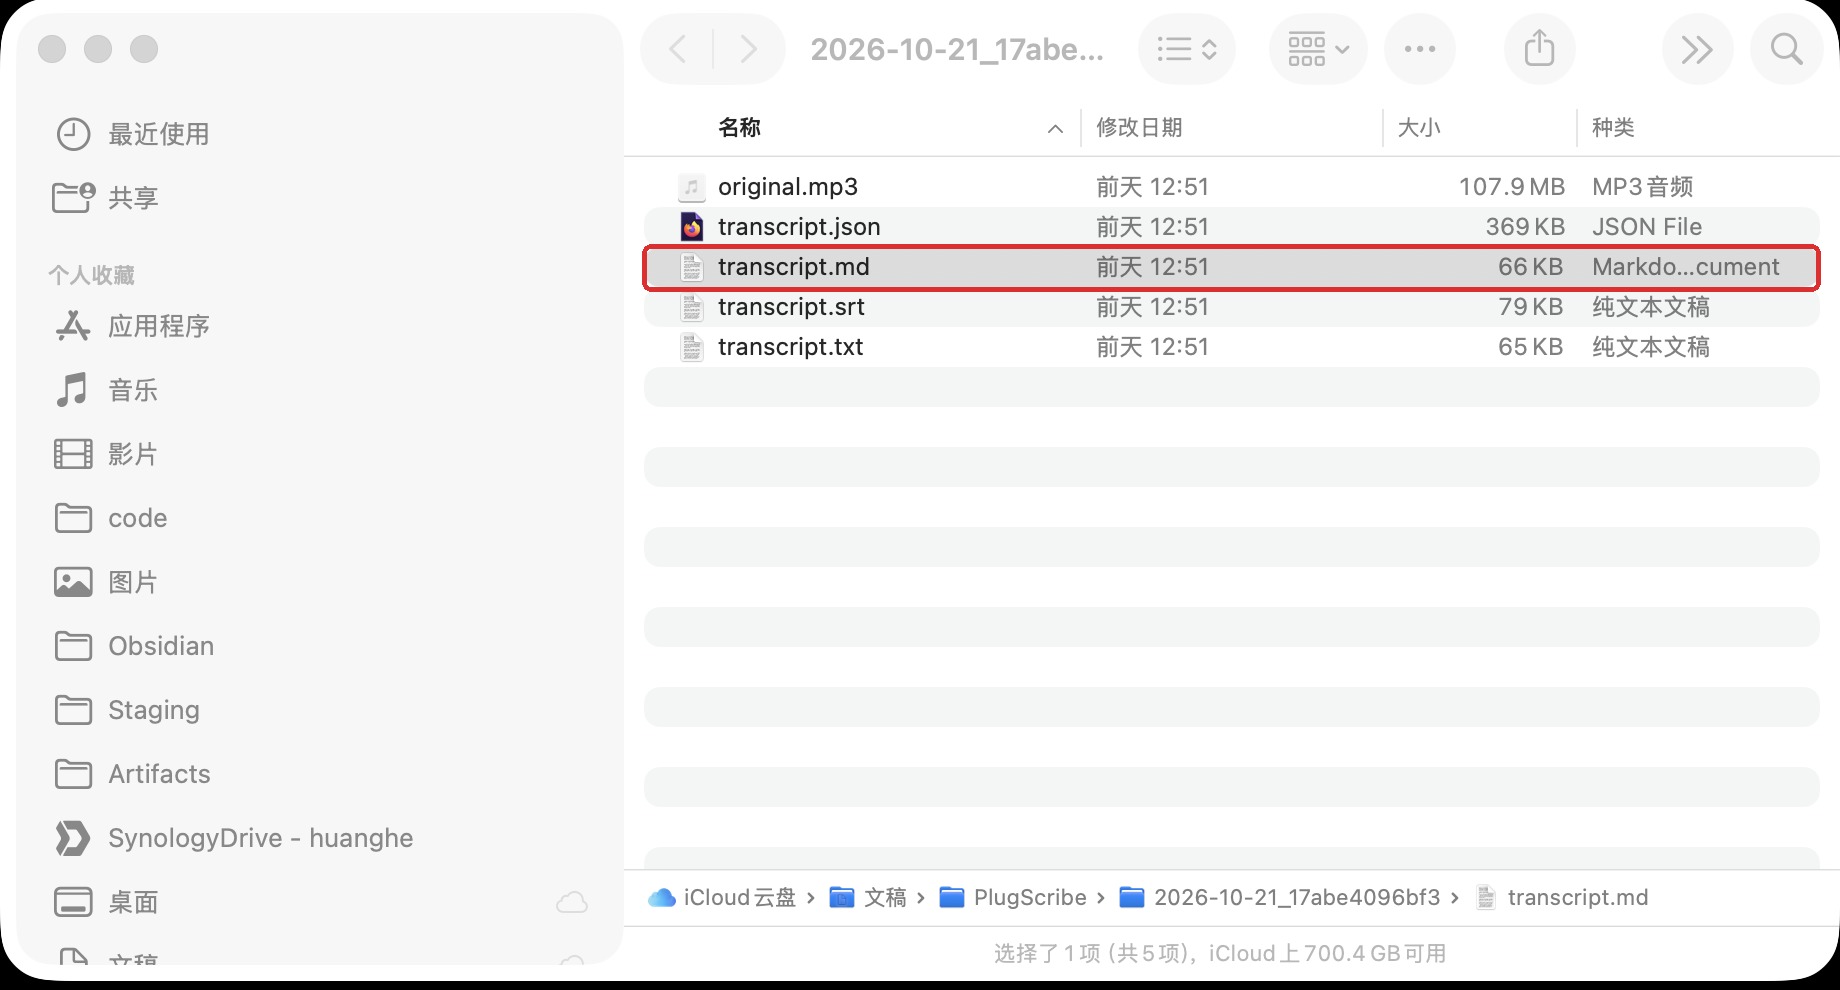
- 点击「打开稿件」旁边的文件夹图标。Finder 会打开这段录音的真实保存目录;
- 目录里的
transcript.md是 Markdown 逐字稿,transcript.txt和transcript.srt是其他导出格式。
-
基础手动流转:
- 最简单的方式:直接将这个导出的
.md文件,复制或者拖入你的 Obsidian 仓库中。
- 最简单的方式:直接将这个导出的
但如果只是手动拖文件,还算不上“AI 工作台”。接下来我们要让 Agent 正式接管这个过程。
三、 第二步:配置你的工作区——目录、AGENTS.md 与转录模板
很多人第一反应是:“我该把转录文件存到哪里?AI 怎么知道存哪?” 其实非常简单,只需要三样东西:
1. 准备一个专门接收转录的目录
首先,你在 Obsidian 仓库里建一个专门放转录稿的文件夹。
比如我自己用的就是:26_Transcription/。
当然,你不一定要死板地叫 26,你叫 02_RAW/转录/,或者直接叫 会议与录音转录/ 都可以。
关键是:让这批文件有一个固定、干净的落脚点。
同时记下一条原则:这个目录最好设为 immutable: true(不可变归档)。因为录音转出来的逐字稿是现实世界发生过的声音证据,只记录事实,未经你确认严禁让 AI 擅自篡改删减原话。
💡 关于消灭摩擦力与工作区定制:
为什么很多人用 AI,总觉得“能聊天、能写小作文,但一到真实业务里就派不上大用场”?
根本原因不在于模型不够聪明,而在于你日常工作中充斥着大量繁琐而重复的物理动作:找文件、导音频、复制粘贴、切窗口、修错别字、归文件夹……这些看似不起眼的摩擦力,把你的精力消耗殆尽,也把 AI 挡在了真实业务之外。我做这套系统,核心就是为了彻底消灭这些繁琐重复的动作,让数据自己流转起来。
如果你是俱乐部会员,业务场景比较深(跨电商、多微信、线下培训交付等),自己摸索配置往往要踩几十个坑:工作区定制可以直接通过微信 miichl 联系河公子。我会根据你的业务现状,把整套工作台完整配置好,消灭所有数据摩擦力,100% 交付给你一个到手现成可用、能直接替你干重活的专属版本。
2. 在 AGENTS.md 里写一句话,告诉 AI 录音存去哪
建好目录后,你得让 AI 知道这个目录的存在。
AGENTS.md 是你整个工作区的“规则总纲”和“系统路由表”,AI 每次干活前都会先读它。它放在 Obsidian 仓库的根目录,与 26_Transcription/ 等文件夹同级。Obsidian 文件列表默认隐藏 .md 后缀,所以图中显示为 AGENTS;完整文件名是 AGENTS.md。
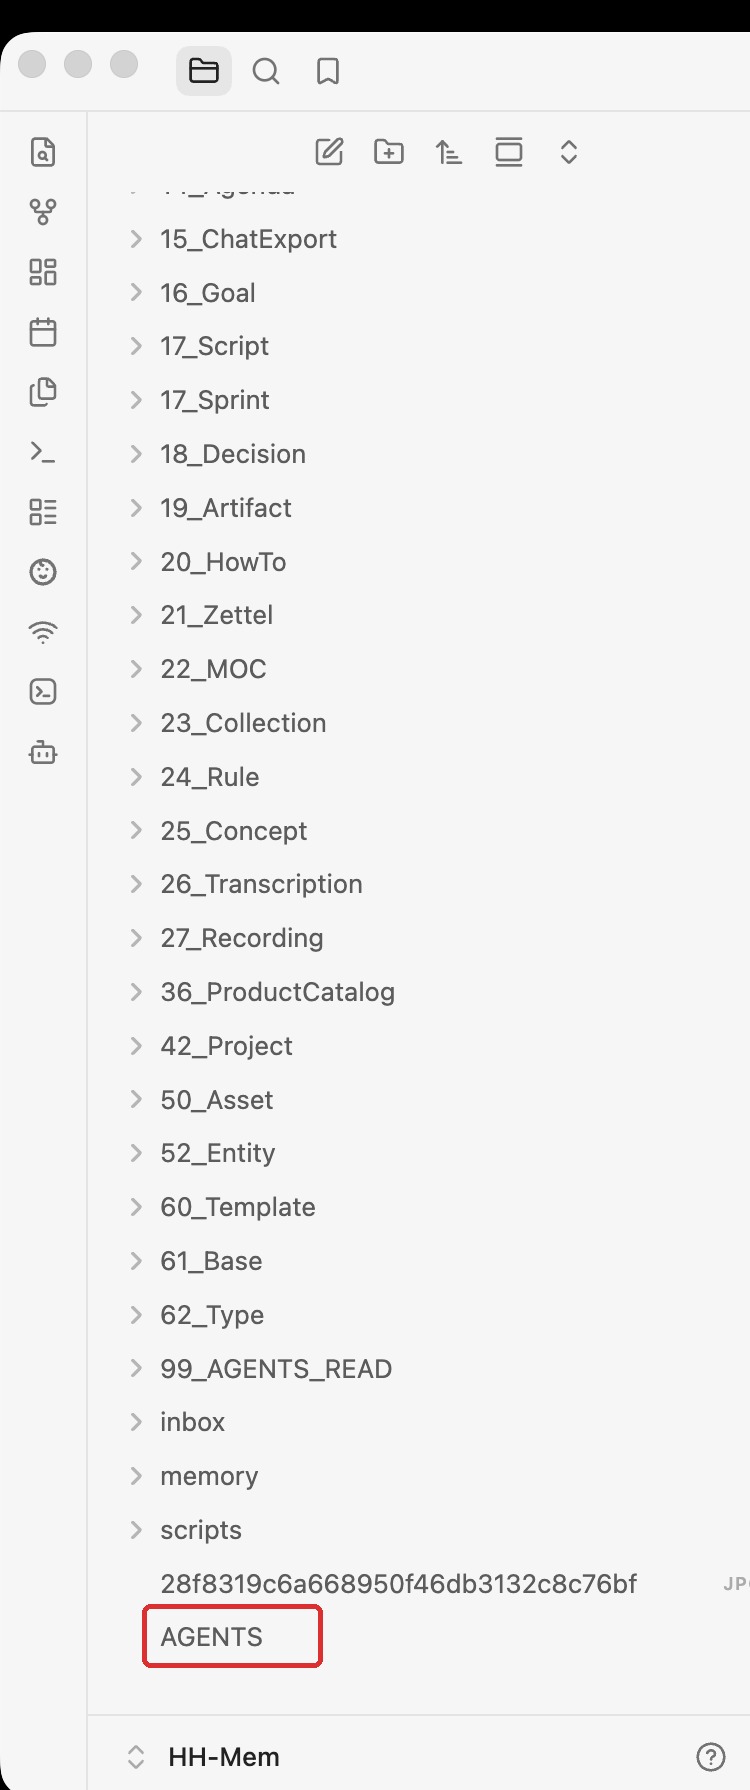
你只需要在 AGENTS.md 的目录规范表里加上这么一行:
| 目录 | 用途 | 命名规范 |
| :--- | :--- | :--- |
| `26_Transcription/` | 真人会议/语音逐字稿原始存档。**immutable: true** | `{转录时间戳}-{主题}-逐字稿文本.md` |
这样一来,下次你对 AI 说:“帮我把这段录音转录稿入库”,它看一眼 AGENTS.md,瞬间就知道该把文件放到 26_Transcription/,并且自动按照时间戳和主题格式命名!
3. 给转录准备一个标准的 Frontmatter 模板
为了让每次录音入库都整整齐齐、带上完整的元数据标签,你可以建一个模板文件。
比如在你的模板目录(或者直接在 26_Transcription/ 里面)建一个名为 tpl.Transcription.md 的文件,内容长这样:
---
id: {{date:YYYYMMDDHHmmss}}
type:
  - "[[Transcription]]"
title: {{title}}
aliases: []
created: {{date:YYYY-MM-DDTHH:mm:ss+08:00}}
meeting_date:
source: PlugScribe 转录;源文件 ``
participants:
  - "[[自己]]"
immutable: true
author: "[[自己]]"
co-author:
related: []
---

# {{title}}

> [!info] 入库说明
> 本文件为真人语音/会议原始逐字稿归档,内容保持客观不可变。

## 逐字稿内容
把这个模板文件准备好后,AI 帮你入库时就会自动套用这个结构:打上准确的转录时间戳、标注参与人、记录是 PlugScribe 转录的原文件来源。
做好这三步,你的工作台就具备了标准的录音接收能力。接下来,我们要让它更聪明——解决错别字问题!
四、 第三步:高级玩法——建立专属 ASR 热词库与自动纠偏
任何语音识别(ASR)引擎,在面对专有名词、行业黑话、人名和中英混杂时,都必然会出现同音错别字。比如:
- 把客户姓名识别成相近的同音字;
- 把“Obsidian”识别成“obsid”或“傲视”;
- 把“wark”识别成“挖客”或“万克”;
- 把“CEO客单”识别成“ceo高客单”。
如果带着一堆错别字直接入库,未来 Agent 在检索和提取知识时就会彻底丢失线索!
真正的工业级工作台,必须配备一个自进化的【ASR 词典与校对规则】!
1. 词库放在哪里?
以河公子的真实系统(HH-Mem)为例,在仓库中建立规则文件:
📂 24_rule/ASR词典与口语转录校对规则.md
2. 词典结构示例
在里面维护一张清晰的误识别映射表:
# ASR 词典与口语转录校对规则

## 1. 高频专有名词映射表

| 常见误识别 | 标准专有名词 | 场景与类型 |
| :--- | :--- | :--- |
| 某客户姓名(匿名示例) | 经核实的姓名(匿名示例) | 客户姓名 |
| obsid / 傲视 / 欧普西迪 | Obsidian | 核心知识管理软件 |
| 万克 / 挖客 / wx ark | wark | 本地微信记忆库工具 |
| run x / unix | Runex | 自研业务引擎 |
| 龙虾 | OpenClaw | 自动化控制 Agent |

## 2. 校对执行铁律
1. Agent 在将任何逐字稿归档入库前,必须先读取本词典,全量纠正文本中的专有名词;
2. 纠错属于“证据清晰化”,修改后必须在笔记顶部留下一行 Callout 修正记录:
   `> [!warning] ASR 修正记录:某客户姓名 → 经核实的姓名(3处)、obsid → Obsidian(1处)`
3. 让 Agent 自进化(自动学习新词)
在日常工作中,一旦你发现有新的人名或产品名被识别错了,你只需在对话中对 Agent 说一句:
“这次录音里有个专有名词被识别错了,正确写法是‘规范写法’,请把这条规则记到 ASR 词典里。”
Agent 会顺手打开 24_rule/ASR词典与口语转录校对规则.md,把这一行自动追加进去。从此以后,你的系统终身不会再犯同一个错!越用越聪明!
五、 第四步:终极玩法——无人值守的全自动录音入库流水线
你平时可能在用 ChatGPT(开 Project)、Claude Desktop、DSH、Cursor、Pi 等各种现代 Agent 工具。如何做到:录音笔一插电脑,你连鼠标都懒得点,文件就自动校对、打标、归档入库?
1. 核心概念扫盲:什么叫“工作目录(Working Directory)”?
很多外行被这个词吓到了。通俗地说:
- 工作目录就是告诉 AI:你现在在这个文件夹里上班。
- 当你在 ChatGPT 或任何 Agent 工具里,把你的 Obsidian 仓库文件夹作为“项目(Project)”或“根目录”打开时,AI 就拥有了读取你仓库里所有文件、遵循
AGENTS.md规则、并把处理结果写入指定目录的物理权限。
2. 设定全自动化提示词(参考模板)
在你的 Agent 工具里,你可以设置一个预设任务或心跳指令,直接给它这套提示词:
你是一个负责数据入库与资产治理的前线工程师(FDE Agent)。
你的工作目录是当前的 Obsidian 知识库仓库。

请执行以下全自动化入库流程:
1. 扫描检测:检查输入目录是否有 PlugScribe 导出的最新转录文本文件;
2. 词典校验:读取 24_rule/ASR词典与口语转录校对规则.md,对逐字稿全文进行专有名词纠偏与替换;
3. 标准归档:
   - 提取文件生成时间,重命名为 `{YYYYMMDDHHMMSS}-{主题}-逐字稿文本.md`;
   - 注入包含 type、created、speaker、source 的完整 YAML frontmatter;
   - 在正文顶部生成 ASR 修正日志 callout;
   - 移动归档至 26_Transcription/ 目录;
4. 深度加工:提取该逐字稿中的 3 个核心业务论点,一键生成原子知识卡片放入 21_卡片/ 目录,并在今日议程中提醒我查看。
配合现代客户端的文件监听或定时心跳,你真正实现了: 白天出门用录音笔录音 → 回家往电脑上一插 → 自动调用 PlugScribe 转录 → Agent 自动比对专属词典校对 → 自动归档并提炼出知识卡片!
六、 今日交付复盘与量身定制通道
从今天起,请彻底告别“手动整理录音”的苦力活。
会员今日实战作业:
- 检查你的仓库,规划好你的语音转录目录并在
AGENTS.md中完成路由登记; - 建立你的第一个
24_rule/ASR词典与口语转录校对规则.md,把你自己名字、公司名、核心产品名填进去; - 用 PlugScribe 录制一段 1 分钟的语音测试,让 Agent 按照词典校对入库一次,体验全自动工业级落地的快感!
🚀 工作区定制服务:
为什么大多数人的 AI 永远停留在“聊天玩具”,无法成为真正能干活的生产力?
因为真实的业务里全是摩擦力:输入不顺畅、数据孤岛、格式混乱、手动搬运。把这些繁琐重复的脏活累活全部消灭,AI 才能真正进入你的生意。如果你的业务场景比较深(跨电商、多微信多账号、复杂线下交付),不想在底层环境和规则调试上耗费宝贵时间,可以通过微信 miichl 联系河公子,预约专属工作区定制。
我会根据你的业务现状,现场为你梳理数据流、打通底层通信管道、配置好专属目录与自动化规则,彻底消灭业务摩擦力,100% 给你交付一个到手即开即用、深度契合你生意的现成工作台。精力有限,成熟业务带真实需求来聊。